Mercedes scraper – Python script
Mit Mercedes Scraper Projekt markerede min første freelanceopgave og blev en spændende udfordring indenfor dataindsamling og behandling. Opgaven bestod i at scrape hele Mercedes’ hjemmeside for information om alle Mercedes-biler og de ekstra pakker, man kunne tilkøbe. Målet var at skabe en omfattende database med alle relevante data, som kunden kunne bruge til videre analyse og beslutningstagning.
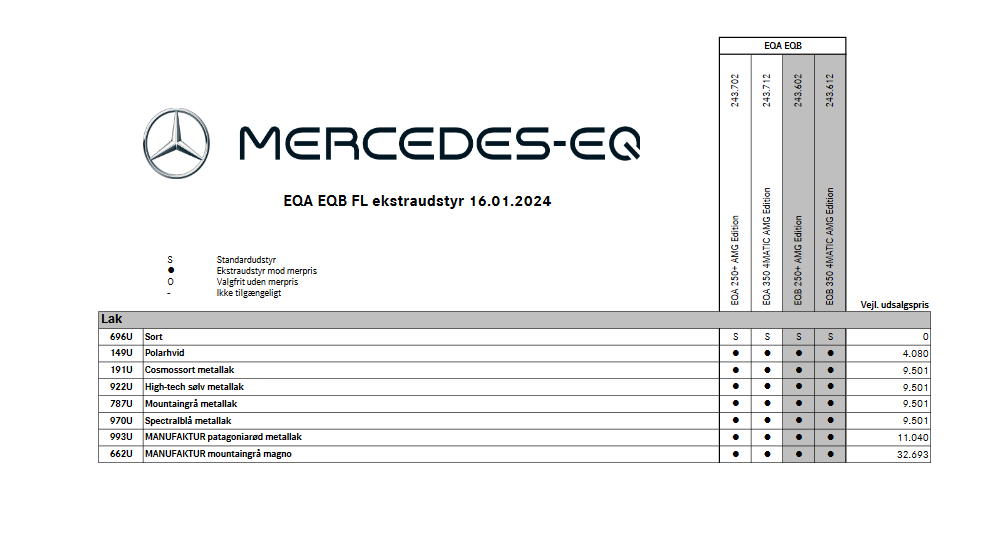
For at løse opgaven udviklede jeg en løsning, der automatisk downloadede PDF-filerne for prislisterne fra Mercedes’ hjemmeside. Disse PDF-filer indeholdt detaljerede oplysninger om bilmodeller og tilkøbsoptioner. Ved hjælp af Python og forskellige PDF-læsebiblioteker kunne jeg udtrække og mappe dataene præcist.
Processen involverede følgende trin:
- Automatiseret Download: Scriptet downloadede systematisk alle PDF-prislister fra Mercedes’ hjemmeside.
- Dataudtrækning: Ved hjælp af PDF-læsebiblioteker i Python blev relevante data udtrukket og struktureret fra PDF-filerne.
- Data Mapping: De udtrukne data blev omhyggeligt mappet for at sikre korrekt struktur og sammenhæng.
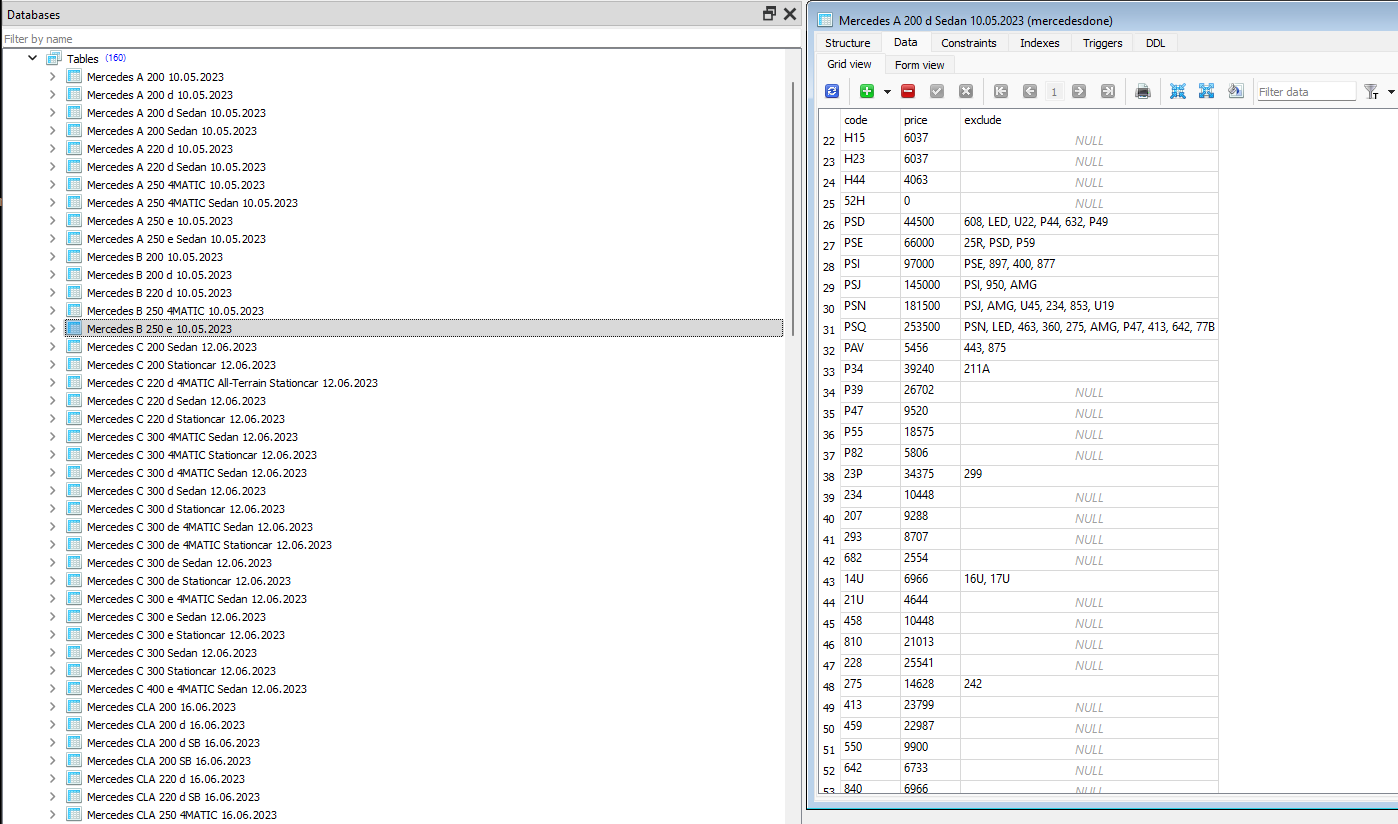
- Database Integration: De behandlede data blev derefter indsat i en SQL-database, som til sidst blev leveret til kunden.
Projektet krævede både teknisk kunnen indenfor web scraping og datahåndtering samt præcision for at sikre nøjagtige og komplette data. Ved at bruge Python som hovedværktøj, kunne jeg effektivt automatisere processen og levere en robust løsning til kunden. Dette projekt gav mig værdifuld erfaring indenfor dataindsamling, behandling og databasehåndtering, som har været grundlæggende for mine fremtidige projekter.
Det var et super udfordrende projekt, da mange af PDF filerne havde forskellige struktur. Så de var meget svære at parse, men med en del timer arbejdet kunne det lade sig gøre.